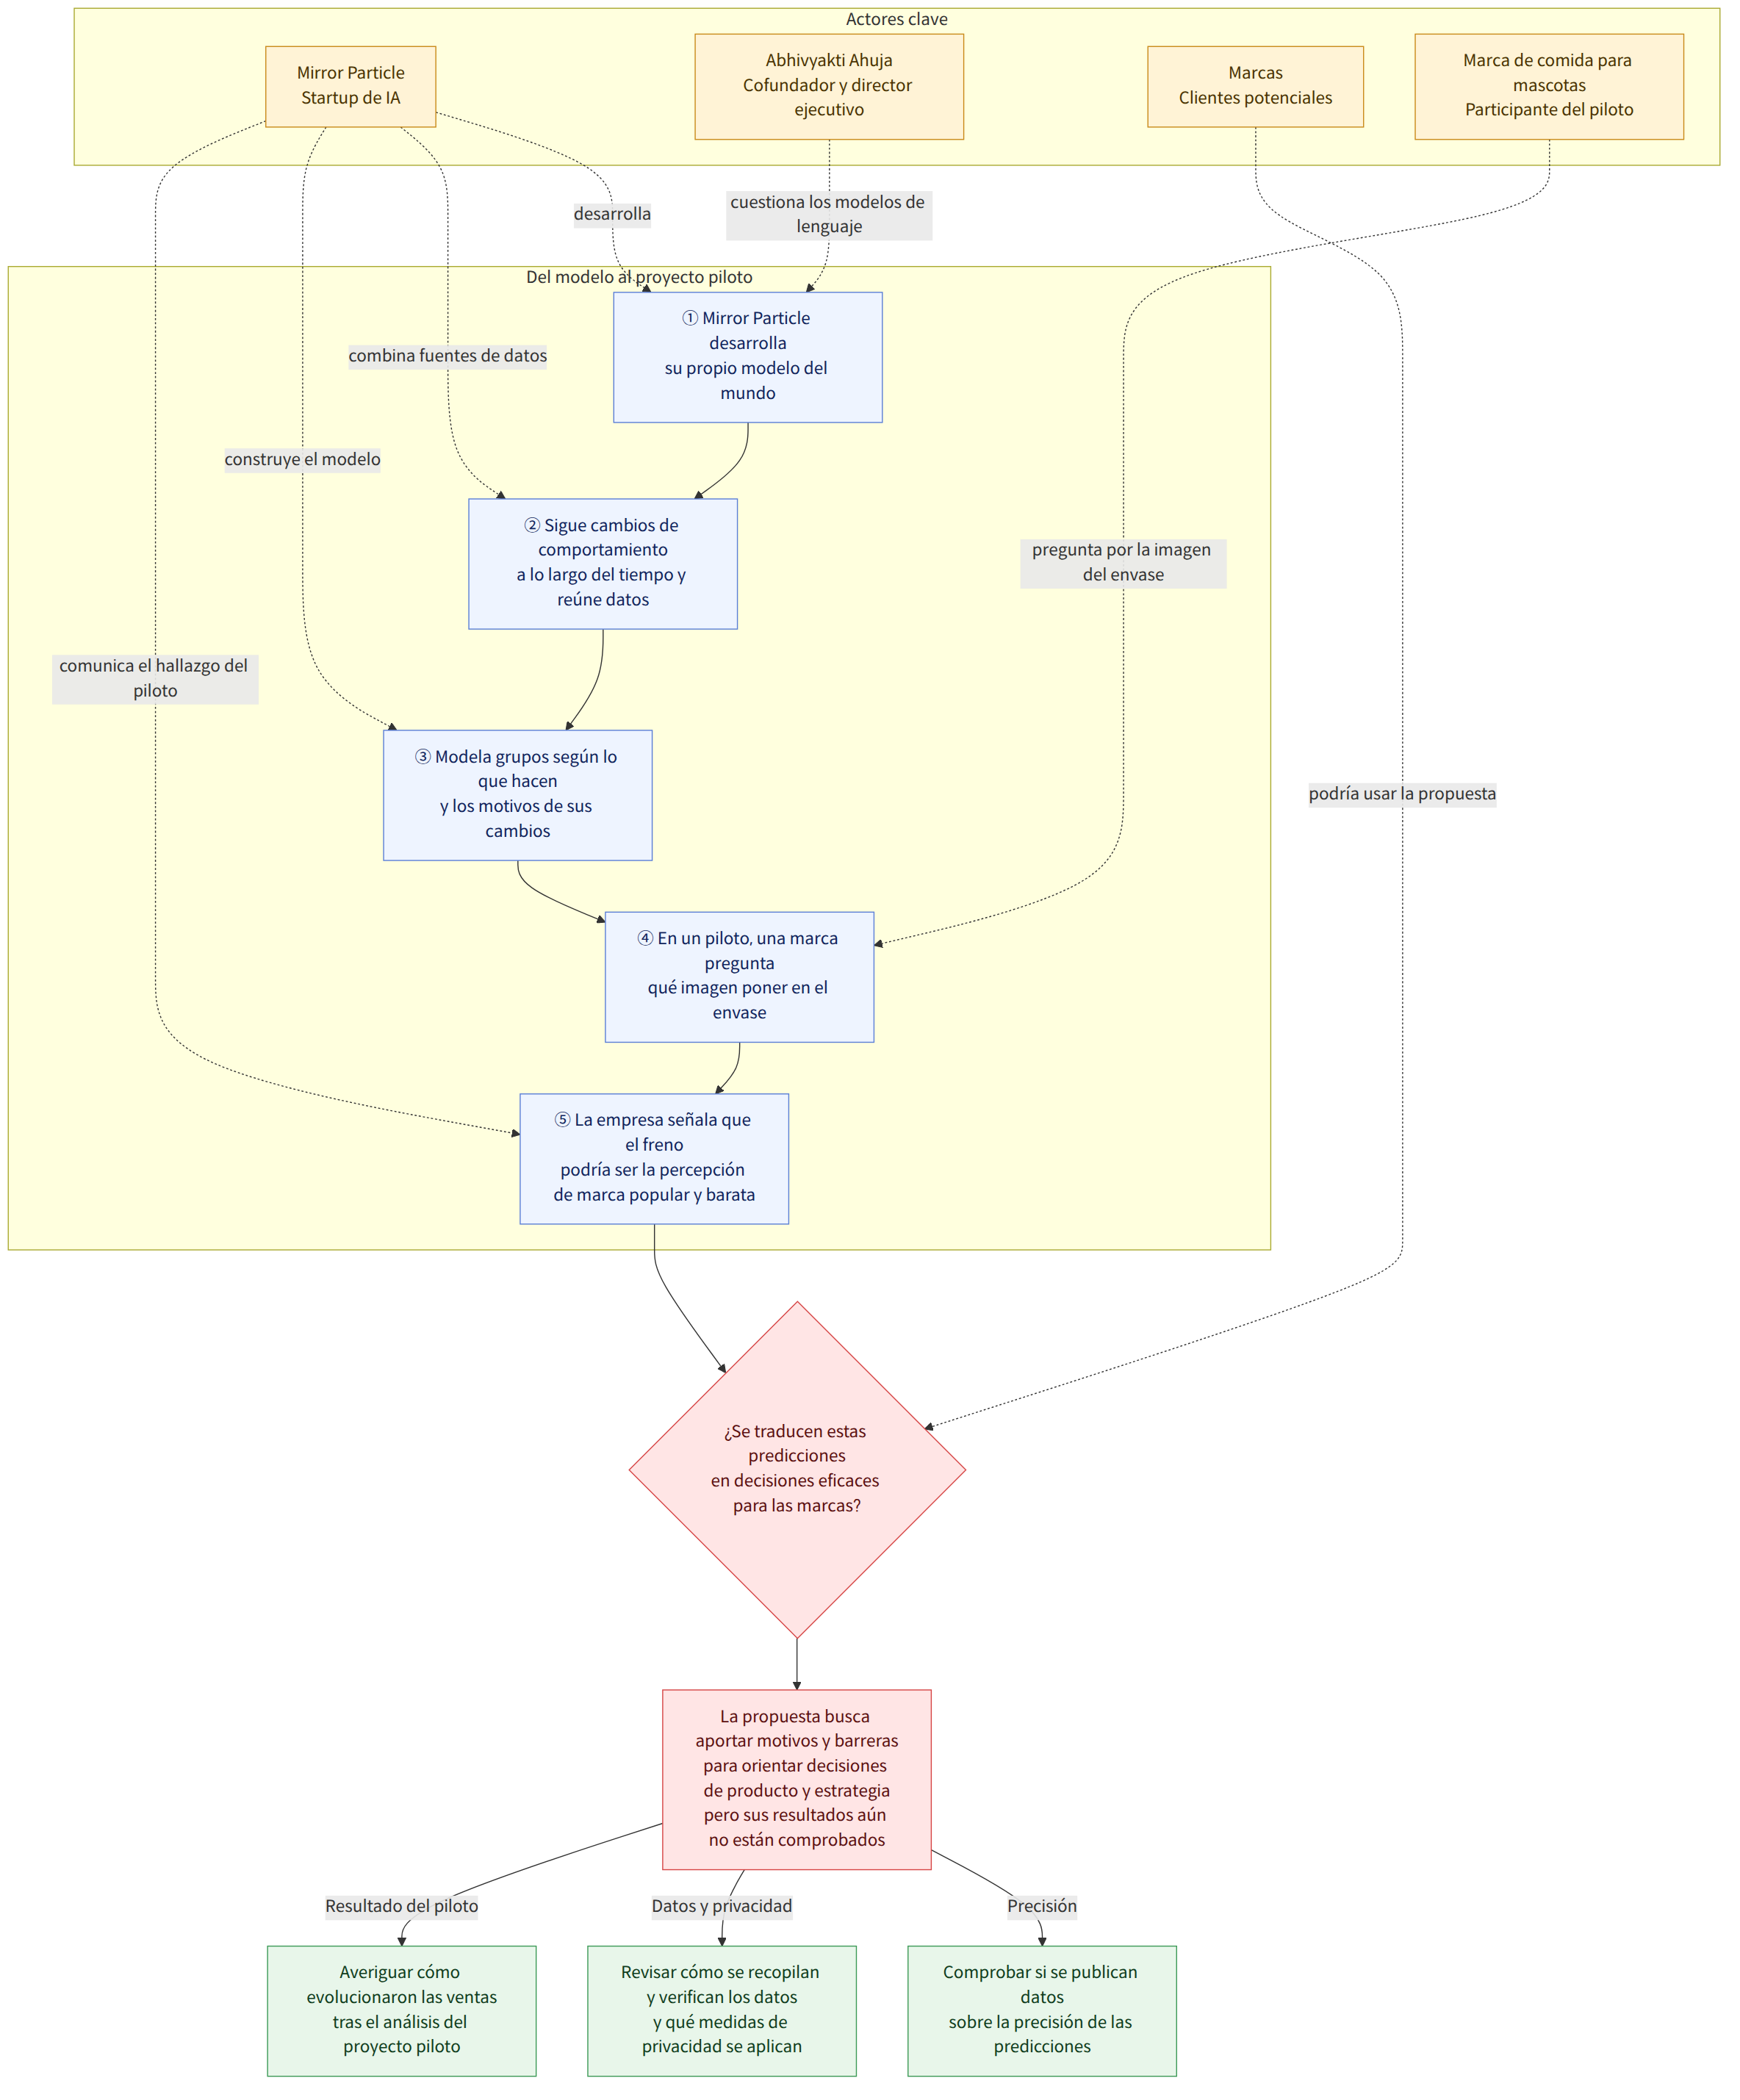
La startup Mirror Particle, con sede en San Francisco, ofrece a las marcas un motor de IA para predecir el comportamiento de los consumidores y sus motivos, y está desarrollando su propio «modelo del mundo». Su cofundador y director ejecutivo, Abhivyakti Ahuja, sostiene que los modelos de lenguaje grandes (IA que procesa el lenguaje tras aprender de enormes cantidades de texto) tienen limitaciones fundamentales para predecir el comportamiento humano. En vez de ajustar modelos de lenguaje, la empresa se propone crear desde cero un modelo fundacional (un modelo de IA de base diseñado para servir a diversos usos) que simule a lo largo del tiempo qué hacen las personas y por qué cambian su comportamiento.
Antecedentes y contexto
Las empresas de IA que buscan predecir el comportamiento humano siguen atrayendo inversiones y lanzando productos. Según el artículo, Simile recaudó 200 millones de dólares durante el último año con una valoración de 2.000 millones de dólares, y Aaru obtuvo 88 millones de dólares con una valoración de 1.000 millones de dólares. Humans& anunció en enero una ronda semilla de 480 millones de dólares con una valoración de 4.480 millones de dólares y, posteriormente, lanzó Persimmon, un producto de modelado del comportamiento humano.
Junto con estos casos, el principal punto de competencia es qué datos se utilizan para representar a las personas y de qué manera. Ahuja considera que los enfoques existentes se apoyan en asignar a los modelos de lenguaje grandes el papel de un grupo demográfico concreto o en entrenarlos adicionalmente, pero que el lenguaje en el que se han entrenado principalmente no equivale a la percepción, la comprensión espacial ni la inteligencia social humanas reales. Esta es una objeción planteada por la empresa; el artículo no presenta resultados que comparen directamente el rendimiento de los modelos de lenguaje existentes con el de Mirror Particle.
Mirror Particle explica que modela a las personas no como un conjunto de características fijas, sino como seres que cambian con la experiencia. Según Ahuja, la empresa sigue longitudinalmente cómo cambian las personas, qué desencadena esos cambios y en qué medida se producen, mediante datos longitudinales (información obtenida al observar a las mismas personas o grupos a lo largo del tiempo). La empresa también considera una señal el hecho de que no se produzcan cambios.
Los datos de propiedad exclusiva que utiliza la empresa incluyen datos de clientes, información de actualidad, cultura popular y redes sociales. La empresa los combina para modelar grupos demográficos concretos y se centra en lo que las personas hacen realmente —el «comportamiento revelado»—, en lugar de lo que dicen en las encuestas. Sin embargo, el artículo no especifica el volumen de los datos, cómo se recopilan y verifican ni qué procedimientos de protección de la privacidad se siguen.
Qué significa esta noticia
La diferencia que destaca Mirror Particle es que ofrece a sus clientes no solo predicciones de comportamiento, sino también el contexto de las motivaciones, las limitaciones y las recomendaciones relacionadas con ese comportamiento. La empresa pretende ayudar a las marcas a ir más allá de preguntar qué elegirán ciertos consumidores y a examinar qué factores impiden o impulsan esa elección para incorporarlos a la toma de decisiones. Para captar a sus primeros clientes, se centra en ámbitos con presupuestos ya destinados a estas actividades, como la investigación de mercado y la estrategia de marca y de producto.
Un caso de un proyecto piloto inicial muestra cómo podría utilizarse este enfoque. Una conocida marca de comida para mascotas preguntó qué imagen debía incluir en el envase —de pollo, ternera o verduras— para aumentar las ventas. Mirror Particle concluyó que el problema no era la imagen, sino la percepción de que la marca era popular y barata, y que las ventas podrían estancarse si esa percepción no cambiaba. Este es el resultado de un proyecto piloto comunicado por la empresa; el artículo no indica cómo evolucionaron las ventas después de ese análisis.
Por ejemplo, si una marca duda qué imagen utilizar en un anuncio de un producto concreto, este enfoque podría intentar averiguar, en vez de limitarse a preguntar qué imágenes gustan, si el grupo objetivo desea el producto en sí y si hay percepciones o limitaciones que dificultan su compra. Sin embargo, no se puede afirmar que este tipo de análisis mejore las ventas. El artículo no proporciona cifras que permitan comprobar la precisión de las predicciones del modelo de Mirror Particle ni los resultados de sus clientes.
Ahuja dijo que el modelo evolucionará de una manera similar a como un bebé aprende sobre el mundo, desde la visión hasta el lenguaje, la conciencia corporal y la inteligencia social. La visión a largo plazo de la empresa es pasar del análisis de grupos demográficos amplios a obtener perspectivas individuales y convertirse en una base general para predecir el comportamiento humano. Esta es la dirección que la empresa ha declarado; no significa que ya se haya implementado una función de predicción individual.
Hechos confirmados y cuestiones aún desconocidas
Hechos confirmados
- Mirror Particle es una startup que está en su segundo año y ofrece a las marcas un motor de IA para predecir el comportamiento de los consumidores y sus motivos.
- La empresa afirma que combina datos de clientes con información de actualidad, cultura popular y redes sociales, entre otros, y que se centra en el comportamiento real más que en las respuestas a encuestas.
- En un proyecto piloto inicial, analizó que el estancamiento de las ventas de una marca de comida para mascotas se debía a la percepción de la marca y no a la imagen del envase.
- La empresa dijo que había cerrado una ronda de inversión ángel y que estaba a punto de cerrar su primera ronda de capital riesgo.
- El artículo señala que la semana que viene está previsto que participe en Startup Battlefield 200 de TechCrunch Disrupt, que se celebrará en San Francisco del 13 al 15 de octubre de 2026.
Cuestiones aún desconocidas
- No se han hecho públicos el importe de la ronda de inversión ángel ni los inversores.
- Se desconoce el tamaño y las condiciones finales de la primera ronda de capital riesgo, que la empresa dijo que estaba cerca de cerrar.
- El artículo no permite conocer la precisión de las predicciones del modelo, los resultados de comparaciones con métodos existentes ni los resultados reales de los clientes.
- Tampoco se especifican las fuentes concretas de los datos ni cómo se procesan y protegen.
Qué pueden comprobar los lectores
- Si se está considerando una herramienta de este tipo para la estrategia de marca o de producto, conviene revisar tanto las recomendaciones como los datos de comportamiento que las sustentan y las explicaciones de las motivaciones y limitaciones.
- Teniendo en cuenta la premisa de la empresa de que las respuestas a encuestas pueden diferir del comportamiento real, se puede preguntar en qué datos y procedimientos de validación se basan las predicciones.
- Sobre la financiación, solo se ha confirmado lo que declara la empresa: que cerró una ronda de inversión ángel y que está cerca de cerrar su primera ronda de capital riesgo. Debe comprobarse si se publican por separado el importe y las condiciones concretos de la inversión.